Obsidian全面切换到Inkstone

最近发现的一个很不错的笔记工具:Inkstone

直接把笔记托管在 Cloudflare 上,自动备份,升级也很方便。

inkstone_screenshot

根据介绍,fork 一份仓库即可使用,中途出错的话一般是没有打开 Cloudflare 某些权限,构建时会有提示。

升级就是去自己 fork 的仓库,点一下同步,Cloudflare 这边就会自动重新构建。

除了没法从 Obsidian 导入导出外,我觉得已经很完善了。

对我来说倒也不是什么问题,我以前爱收集一些脚本片段,到了 AI 时代直接重写就行了,根本就没有备份的必要了。
笔记太多的话,导入导出其实也可以让 AI 来处理……

Muse Code 接入任意模型

最近 Meta 发布一个编码工具,考虑到如今 Harness 如日中天,突然觉得此前 Meta 意欲收购 Manus 也没那么离谱了。尽管工具本身关注度不高,不过因其号称在健壮性方面很强(可能参考过 Manus 的思路),所以打算看看。

Muse Code 不支持第三方模型,但提供了20美金试用,愿意分享数据的话,可以用很久。
程序本身也没什么设防,即使没文档,接入第三方也不算艰难。
研究过程比较零碎,直接抛结论,具体实现在文末的 PoC。

首先,muse 启动参数有几个重要项:

  • META_API_KEY 作为环境变量输入时,比浏览器授权优先级更高。不经 TUI 设置可以跳过 KEY 验证,直接进入界面;
  • --base-url 可以设置 Meta API ,可能是用作镜像,也可以 mock 一个私服作为中转;
  • --model--provider 是设置默认模型,与 base-url 返回的结果对应。

对应的启动方式形如:META_API_KEY="dummy-key" muse --provider meta --base-url http://127.0.0.1:9911 --model glm-5.2 --yolo

base-url是本地搭建的中间层,用来提供模型目录和转发对话。

具体而言,muse 会从 {base-url}/muse-code/models 获取模型列表,官方模型只有 spark 系列,我们可以返回自定义结果。示例:

{
  "schema_version": 1,
  "data": [
    {
      "provider_id": "meta",
      "profile_id": "default",
      "id": "glm-5.2",
      "model_id": "glm-5.2",
      "display_label": "Z.AI/GLM-5.2",
      "visibility": "visible",
      "release_date": "2025-01-01",
      "display_order": 1,
      "is_current": true,
      "is_default": true,
      "context_limit": 65536,
      "output_limit": 8192,
      "description": "Third-Party Model via muse proxy"
    }
  ]
}

具体的对话走 OpenAI Responses 格式接口({base-url}/v1/responses)。

上下文窗口控制和压缩:

  • 默认达到 80% 触发摘要压缩,90% 进行强制硬压缩;
  • settings.json 、CLI 和远程模型信息均可控制窗口,本地设置优先于远程;
  • 可以额外控制是否清除工具输出,默认是清除。

之前的示例已经展示远程模型列表如何传入窗口,以下是 settings.json 示例,优先级更高:

{
  "schema_version": 1,
  "run": {
    "reminder_roster": {
      "interval_steps": 999999,
      "skip_if_running": true,
      "max_in_flight_per_agent": 1
    },
    "context_compaction": {
      "soft_threshold": 0.8,
      "hard_threshold": 0.9,
      "provider_context_limit_tokens": 32768,
      "tool_result_clearing_enabled": true
    }
  }
}

btw:对应的 CLI 参数(一般无需使用)是 --context-compaction-soft-threshold / --context-compaction-strategy / --max-tool-output-bytes

可以看到,在配置文件中还有一个reminder_roster
在实际调度中,每次回应后会有几秒的延迟,显示 Finishing up,期间程序会发起多次额外对话:

  • scope reminder(与对话调用并发)
  • approval judge
  • goal reminder
  • verification watcher
    简单来说,就是 muse 在发起额外检查,确保操作没有越界、真的完成任务。它还引入了一个二号观察员,用来监督检查是否真的起效(可以说是有迫害妄想症)。

如果想要关闭或者调整,可以配置reminder_roster,按需设定:

  • interval_steps :执行多少步开始检查,默认可能是1,大数等同于跳过;
  • skip_if_running:如果已有 reminder 在运行,跳过本次调度;
  • max_in_flight_per_agent:每个agent 最多几个并发 reminder。

至此,我们已经有了大致信息,可以完成一个简单的中间层,通过 CC-Switch、New API 等工具,我们也可以接入 /chat/completions 端点。

具体的中间层可以查看这份:PoC

邪修速验Huggingface Inference Token

官方的接口是:

curl https://huggingface.co/api/whoami-v2
    -H "Authorization: Bearer hf_..."

不过该接口疑似有速率限制,尤其是IP可能受限。

邪修速通方案:401/403是无效,400/404是有效

curl 'https://router.huggingface.co/groq/-' \
  -H 'authorization: Bearer hf_...'

原理是router会先验token,一般错误的会返回401,官方封号是403。由于第三方供应商不支持GET,所以正确时会返回400。
404比较特殊:hf-inference作为供应商(即替换groq)时是支持GET的,但url中要求包含模型名称,模型不存在所以404。

如需要进一步确认是否还有额度,可使用免费模型验证,如:

curl 'https://router.huggingface.co/novita/v3/openai/chat/completions' \
    -H 'authorization: Bearer hf_...' \
    -H 'content-type: application/json' \
    --data-raw \
        '{"messages":[{"role":"user","content":"Hi"}],"max_tokens": 1,"stream":false,"model":"meta-llama/llama-3.2-1b-instruct"}'

附上两份价格表:
Requesty通用价格
HuggingFace价格(有细微偏差,要以账单接口为准)

尝试一下vibe coding

简单玩了下最近很火的 vibe coding。

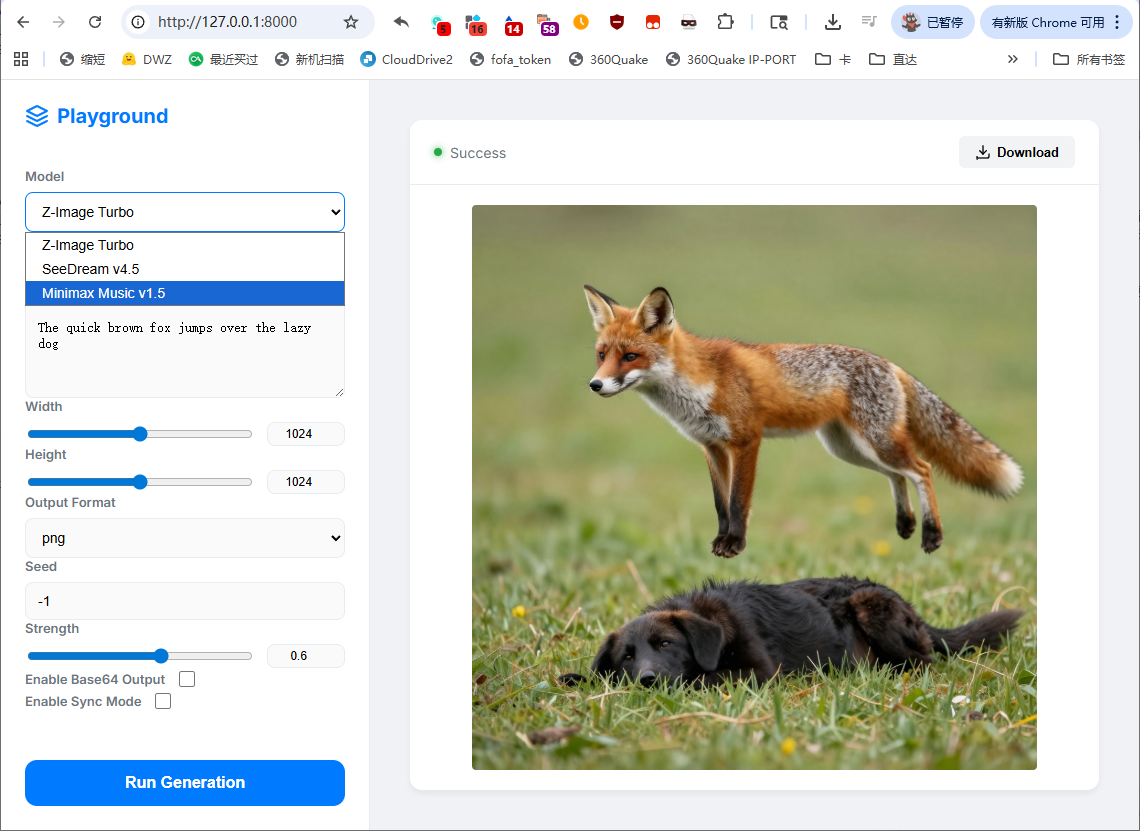
根据API做了个模型playground,没用什么工作流,就是古法聊天。

界面如下:

在 Antigravity 中使用 Gemini 3 flash 完成,一共就四轮对话,还挺好玩的:完整的 prompt

带善人HuggingFace搞了点新接口

很久没去 HuggingFace,发现又多了一些第三方 LLM 接口,并且特地做了一个支持直接调用的 LLM 列表。可以看到,最全的依然是 novita,其他基本是凑数的。

不过,最大的发现是,图片生成增加了一家供应商:WaveSpeed。相比不能试用的 fal 和审核很严的 Replicate,WaveSpeed 可以说是可用性极高。

配合以前的一个小技巧——HuggingFace 实际支持第三方接口的所有模型(包括不在 HuggingFace 上的闭源模型),我们还可以 router 调用 Nano-Banana。

还不止于此,只要接口统一,其他任何模型,甚至是音乐生成模型,也能调用。

# pip install wavespeed
from wavespeed import Client

hf_key =  YOUR_HF_KEY
hf_base_url = "https://router.huggingface.co/wavespeed"

def text_to_music(prompt, lyrics, model):

    client = Client(api_key=hf_key, base_url=hf_base_url)
    output = client.run(
        model,
        {
            "bitrate": 256000,
            "lyrics": lyrics,
            "prompt": prompt,
            "sample_rate": 44100
        },
        timeout=36000.0,
        poll_interval=1.0,
        enable_sync_mode=False,
    )

    return output["outputs"][0]

model = "minimax/music-02"
prompt = "一首中式古典歌曲,由古筝弹奏,由轻柔的男声演唱"
lyrics = "窗前明月光,\n疑似地上霜。\n举头望明月,\n低头思故乡。"
print(text_to_music(prompt, lyrics, model))

可以说,HuggingFace 的 router 就是真是个 router。实践中,并不是所有的供应商都能随意跨模型,例如:不能用 replicate 的 LLM;调 novita 非 LLM 服务结果会截断。这不是因为 HuggingFace 做了限制,而是 router 这块代码够烂。可能这块是 vibe coding出来的?

简单的免费SSL证书生成网站

由于需要 HTTPS,稍微找了一下手动生成方案,目前最方便似乎是PunchSalad。每次生成 Let's Encrypt 可以提供90天的免费证书。

据我了解,AMH、SSL For Free 也有申请证书的服务,不过还要注册,不如 PunchSalad 方便。

之所以需要手动生成,是因为之前在「支付宝-小程序云」上托管了几个静态页面:前情提要。这个「小程序云」自然是无法自动续期证书的,只能手动。顺带一提,这个空间不支持通配符证书……

背景

之前,我想用自己的域名做短链,从而避免烂大街的域名被微信、QQ 限制。试用了国内的服务,凡是免费层级都不让用 HTTPS,而且必在跳转时随机插广告(借口被运营商劫持,其实根本就是服务商自己搞鬼)。

后来退而求其次,找到了替代品:搜狐快码。直接购买的门槛比较高,通过好单库生成,可以用多少充多少,性价比比较高。一些国内企业建立的 Yourls 服务也挺好用,因为过于小众,又有备案,不容易被限制。

至于静态托管的问题,似乎今年阿里云的免费 ESA 也上线了,也许托管到 Github Pages 再套个 CDN 更省事,有空再试试看。

玩点老资历赛车游戏

最近突然想玩点赛车游戏,稍微看了一下,好家伙一个个都动辄几十G,瞬间就不想玩了。

突然想起来当年有个单机版的跑跑卡丁车,没想到现在已经进化到可以玩最新地图了,还可以AI填充。

启动器:yanygm@github/Launcher_V2
客户端:brownsugar@github/popkart-client-archive

3个G还是可以的,还是个绿色版~

开得一塌糊涂,只能玩玩简单AI,还不如以前小板车跑得快(扶额)

很不错的K歌软件——剪映

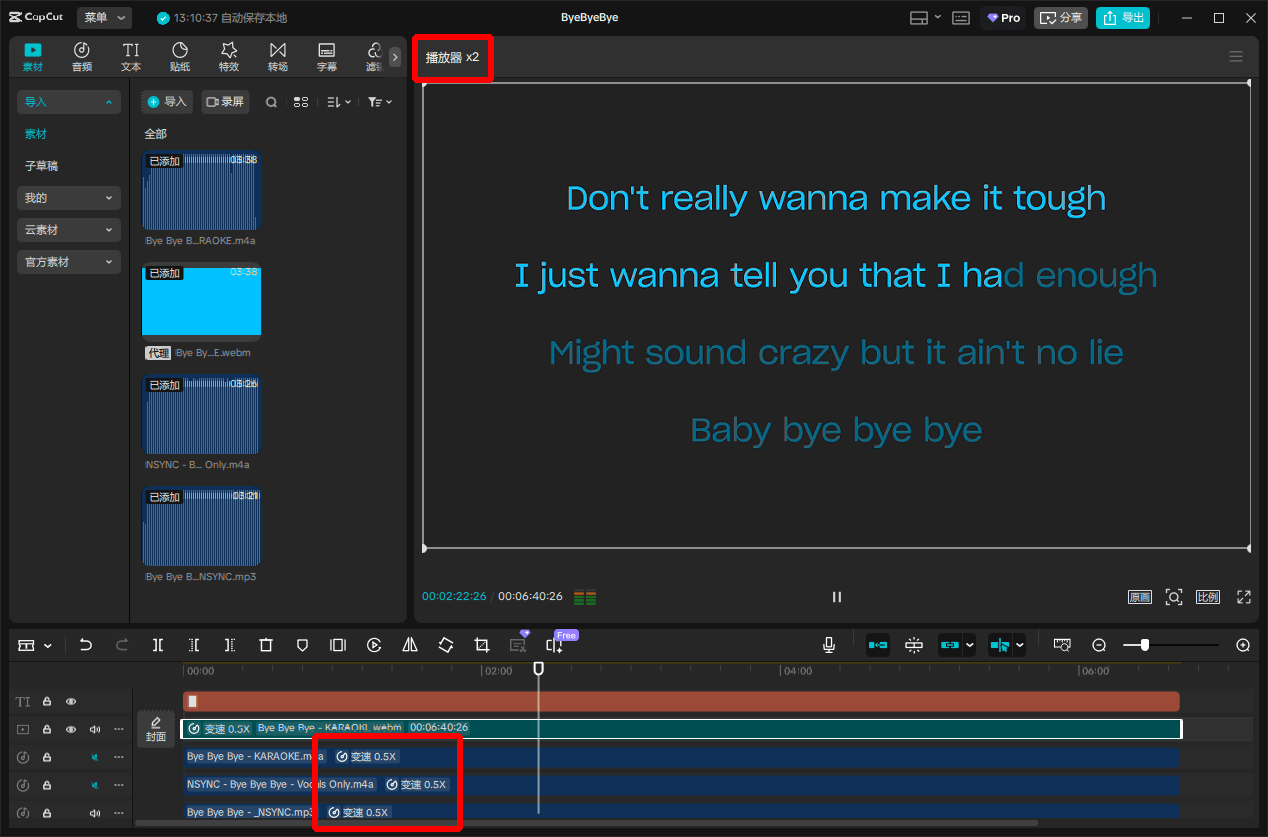
最近在试唱英文歌,发现市面上的K歌App都不好用,最终动用了视频剪辑软件。

视频剪辑软件的优点:

  • 歌存在大量连读,还有省略发音,所以一开始会频繁用到倍速播放。很多剪辑软件都支持J K L预览倍速。我把原曲调成了0.5倍速,通过双击L播放,J快退,很方便。
  • 网上现成的背景音素材很多,分开导入音乐和人声,可以方便静音某个音轨。

剪映的优势:

  • 小、免费(相比 Premiere pro)
  • 加速不会卡顿爆音(相比 Kdenlive)
  • 自带 AI 人声分离(这条不算重点)

其他方案的问题:

  • 播放器不支持多音轨同时播放,如音乐和人声合并/独立播放
  • 传统 K 歌软件不方便变速
  • 混音软件不能展示歌词画面

记一次系统内存泄漏排查

我习惯使用Windows睡眠,很少关机。但是系统总是越用越卡,最终不得不重启。这个情况持续了很长一段时间,64G的内存基本上只能支撑1-2周,并且一直找不到原因。

最近,这个问题终于彻底解决。流程和和这篇《win10非分页缓冲池占用过大的解决方法》几乎一致。

内存泄漏的情况千奇百怪,总有前人踩过坑。然而,往往要已经定位到问题,才能搜到对应的文章,属于是马后炮了。所以我姑且记录一下自己的流程。


首先,查了一些常见的系统泄漏情况,关闭了微软输入法,无效。
接着,用Process Explorer查找问题,没有异常进程。

继续研究,有一些用户提到显卡驱动有内存泄漏,如果是这种驱动级泄漏,Process Explorer是找不到的。

ChatGPT的解释:

Process Explorer 本身主要用于查看和分析用户模式下的进程和线程活动,比如 CPU、内存、句柄和 DLL 的使用情况。
它不直接提供定位驱动级别内存泄漏的功能,因为驱动程序运行在内核模式下,而 Process Explorer 主要关注用户模式的行为。

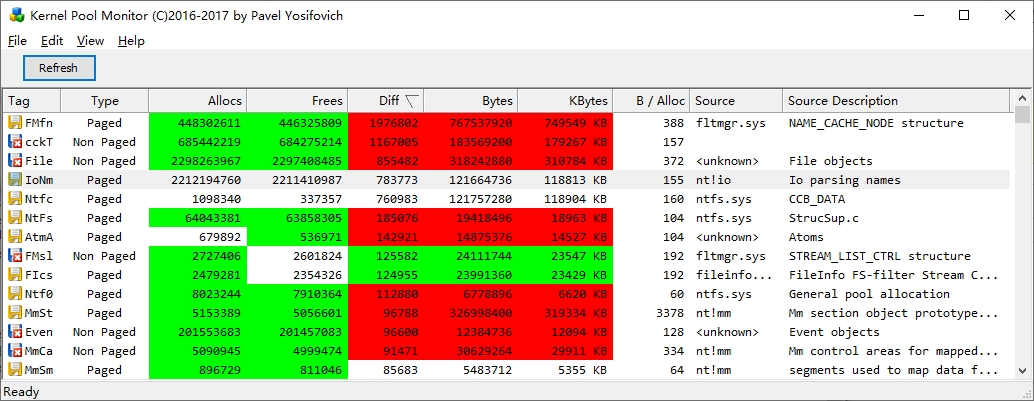
系统开机一段时间后,用PoolMonX查驱动,Diff排序,此时FMfn攀升到第一位。

按照网上的说法,应该要查Non Paged,不过我这里显示是Paged。Diff代表申请和释放内存的差值,如果数字太大,代表没释放的内存在堆积。

C:\WINDOWS\system32>fltmc

筛选器名称                      数字实例       高度          框架
------------------------------  -------------  ------------  -----
cbfs6                                                       <过时>
bindflt                                 1       409800         0
lrtp                                   17       389170         0
sysdiag                                 7       324600         0
storqosflt                              0       244000         0
wcifs                                   1       189900         0
CldFlt                                 10       180451         0
FileCrypt                               1       141100         0
luafv                                   1       135000         0
npsvctrig                               1        46000         0
Wof                                    13        40700         0
FileInfo                               17        40500         0

问一下ChatGPT这都是些什么:

cbfs6:通常与 Callback File System 相关,这是一个用于开发虚拟文件系统的第三方工具。
bindflt:Windows 内置驱动,绑定筛选器驱动程序,用于文件系统绑定操作。
lrtp:未知,这个名称不像常见的系统驱动,可能需要更深入的检查。
sysdiag:未知,名称看似与系统诊断有关,但没有明确的 Windows 系统驱动使用这个名称。
storqosflt:Windows 内置驱动,存储质量服务过滤器,与存储设备的性能管理相关。
wcifs:Windows 内置驱动,Windows 容器隔离文件系统,支持容器化文件操作。
CldFlt:Windows 内置驱动,Cloud Files Mini Filter Driver,用于 OneDrive 等云存储服务的文件占位符功能。
FileCrypt:Windows 内置驱动,文件加密驱动,处理文件级别的加密操作。
luafv:Windows 内置驱动,用户账户控制虚拟化,用于兼容旧软件的 UAC 虚拟化支持。
npsvctrig:Windows 内置驱动,服务触发器提供程序,用于触发基于网络事件的服务操作。
Wof:Windows 内置驱动,Windows Overlay Filter,用于处理压缩和解压缩的文件存取操作(如 NTFS 压缩或 WIM 挂载)。
FileInfo:Windows 内置驱动,文件信息筛选器,用于收集文件元数据,常用于安全审计。

有两个未知,其中sysdiag是火绒。继续定位lrtp.sys

C:\>findstr /m /l /s lrtp *.sys
Program Files (x86)\Lenovo\LenovoInternetSoftwareFramework\lrtp.sys
FINDSTR: 无法打开 swapfile.sys
Windows\System32\drivers\lrtp.sys

原来是联想的东西,搜了一下,这个驱动属于老版本的管家残留,新版本已经换驱动了,所以无法通过装新版再卸载来解决。网上大概有三四篇文章提到这个驱动存在内存泄漏,包括开头提到的那篇。
总之,可以暴力删除,也可以用这篇文章末尾的批处理:《联想电脑管家卸载残留完整分析》

至此,系统内存泄漏问题解决。


题外话,通过这次排查,我才知道任务管理器的使用中内存根本就是文字游戏,备用内存更是毫无意义的数字。

使用中代表这部分物理内存正在使用,但真正不能释放的部分是已提交。打个比方,有人预订了酒店,但他不一定入住,酒店没办法把这些空房安排给其他客人。预订就是已提交使用中就是实际入住,有人占着茅坑不拉屎,不等于茅坑能再次分配。

备用就更没有意义,这个数字等于物理内存总量减去使用中。其中既有不能释放的申请,又包括了可以释放的缓存。这个名称给人一种”这些内存在必要时可以分配给其他应用“的错觉,我不知道计算这个的意义是什么。

内存释放工具主要就是转移这部分内存,这些数据被暂时移到硬盘后,又会被系统慢慢加载回来,所以解决不了内存爆炸后的卡顿的问题,最多只能缓解几分钟。而频繁清理,硬盘压力会变大,只会使系统更加卡顿。

一个典型的例子是Photoshop。在Photoshop中关闭文件后,这部分内存并不会被释放。官方的解释是,软件为了不反复申请内存,所以不释放内存,而是留着给未来的操作重用。实际上,这就是典型的内存泄漏,而且这些内存根本不像官方说的那样会重用。

如果用内存清理软件清理,这些物理内存占用快速下降,但是观察进程管理器,可以看到内存很快又会攀升,并且磁盘忙碌。整个过程最多5分钟,已提交的数字不会变化,等于是这些内存去分页文件逛了一圈。这时候,唯一能做的就是重启Photoshop。

驱动级泄漏最麻烦的地方在于,如果有多个进程或服务在使用这个驱动,很难确定是谁的问题,只能排除法。另外,删除驱动后,需要重启验证,如果泄漏缓慢,可能要等待几天甚至几周才能确定问题是否解决。

Huggingface行了又不太行

最近一段时间,Huggingface做了一点改动。

Space归类

在Space页面,按Space功能加了一行Icon。因为搜索很烂,所以官方归类一下还是不错的。从靠前的Space可以看到比较不错的项目和模型,或者说就是现阶段最好的模型。我试了下靠前的Background Removal项目,就挺好用。

模型接口变化

Huggingface大概在一个月前,接入了其他模型供应商。官方自己的接口一直都很烂,不但容易掉线,非热门模型撤得也快,基本只能当玩具。接入第三方后,自然稳定很多。

但是,配额暴降。之前是FREE账户限制模型范围,PRO账户有20K/M的调用次数。现在缩水到FREE账户$0.1/M,RPO账户$2/M。
我测试了一下,在模型页面右侧的使用Demo也会扣配额。Huggingface没有说具体的计算方式,如果是按调用次数,等于PRO用户砍了九成配额。
当然了,也有办法增加配额,我只能说懂的都懂。

更正:Huggingface是按各个服务商的定价按原价转发。

具体的供应商列表在源码PROVIDER_T里,相应的接口(LLM):`
https://router.huggingface.co/{:PROVIDER}/v1/chat/completions

有意思的是,如果是走第三方供应商,一些Huggingface上不存在的模型也是可以调用的。但不是所有接口都可以,Huggingface对每个供应商只实现了部分接口,具体可以看源码中的定义。

修了一个Bug

Space原本是不支持/v1路径的,访问会404,所以作为LLM接口调用必须要多加一层路径(如/hf/v1),现在似乎修好了。